وقتی سایت قطع شد چه کنیم: از اولین هشدار تا اطلاعرسانی به مشتری
- قطعی سایت
- مدیریت بحران
- پشتیبانی فنی
- تیم عملیات
- مانیتورینگ
قطعی سایت صرفاً یک مشکل فنی نیست؛ بلکه یک بحران ارتباطی و عملیاتی است. این مقاله یک چارچوب عملیاتی (Playbook) ارائه میدهد تا تیمهای فنی و عملیاتی بدانند هنگام قطعی سایت چه کنند؛ از لحظه دریافت اولین هشدار تا ارائه یک پیام شفاف و مسئولانه به ذینفعان.
وقتی سیستمهای آنلاین در معرض خطر قرار میگیرند، لحظات اولیهی واکنش، تعیینکننده میزان آسیب و اعتبار کسبوکار شماست. قطعی سایت صرفاً یک مشکل فنی نیست؛ بلکه یک بحران ارتباطی و عملیاتی است. در شرایطی که ترافیک ممکن است در حال اوج باشد و مشتریان منتظر خدمات شما هستند، واکنش غریزی اغلب منجر به تصمیمگیریهای عجولانه میشود. هدف این مقاله ارائه یک چارچوب عملیاتی (Playbook) است تا تیمهای فنی و عملیاتی شما بدانند که هنگام قطعی سایت چه کنیم؛ از لحظه دریافت اولین هشدار تا ارائه یک پیام شفاف و مسئولانه به ذینفعان.
مرحله اول: تأیید و محدودسازی بحران
اولین و مهمترین گام، جلوگیری از واکنشهای پرهزینه بر اساس هشدارهای کاذب است. قبل از هر اقدامی، باید مطمئن شوید که مشکل واقعی است و دامنه آن چقدر گسترده است.
تأیید صحت هشدار (Alert Validation)
سیستمهای مانیتورینگ ممکن است به دلیل نوسانات شبکه یا پیکهای ترافیکی، هشدارهای غیرضروری (False Positives) ارسال کنند.
- بررسی چندگانه: آیا فقط یک پینگ یا یک تست از یک منطقه جغرافیایی خاص شکست خورده است، یا چندین تست از نقاط مختلف، وضعیت نامناسب را تأیید میکنند؟
- بررسی وضعیت زیرساخت: آیا سرویسهای وابسته (مانند دیتابیس یا APIهای خارجی) نیز در حال گزارش خطا هستند؟
تعیین دامنه اختلال (Scope Definition)
اگر قطعی واقعی است، باید بدانید چه چیزی تحت تأثیر قرار گرفته است. آیا کل سایت از کار افتاده است یا فقط بخش خاصی (مثلاً سبد خرید یا سیستم احراز هویت)؟
- تشخیص لایه مشکل: آیا مشکل در لایه شبکه (Latency بالا)، لایه سرور (CPU بالا/Memory Leak) یا لایه کد (Bug) است؟
- تشخیص تأثیر: آیا این قطعی فقط بر کاربران جدید تأثیر میگذارد یا کاربران قدیمی نیز نمیتوانند وارد شوند؟
چکلیست عملیاتی اولیه:
- [ ] هشدار را با ابزارهای مستقل تأیید کردم.
- [ ] محدوده تأثیر (مثلاً: فقط API پرداخت، یا کل فرانتاند) مشخص شد.
- [ ] تیم فنی مرتبط (Backend، Frontend، DevOps) مطلع شدند.
مرحله دوم: واکنش عملیاتی و مدیریت بحران
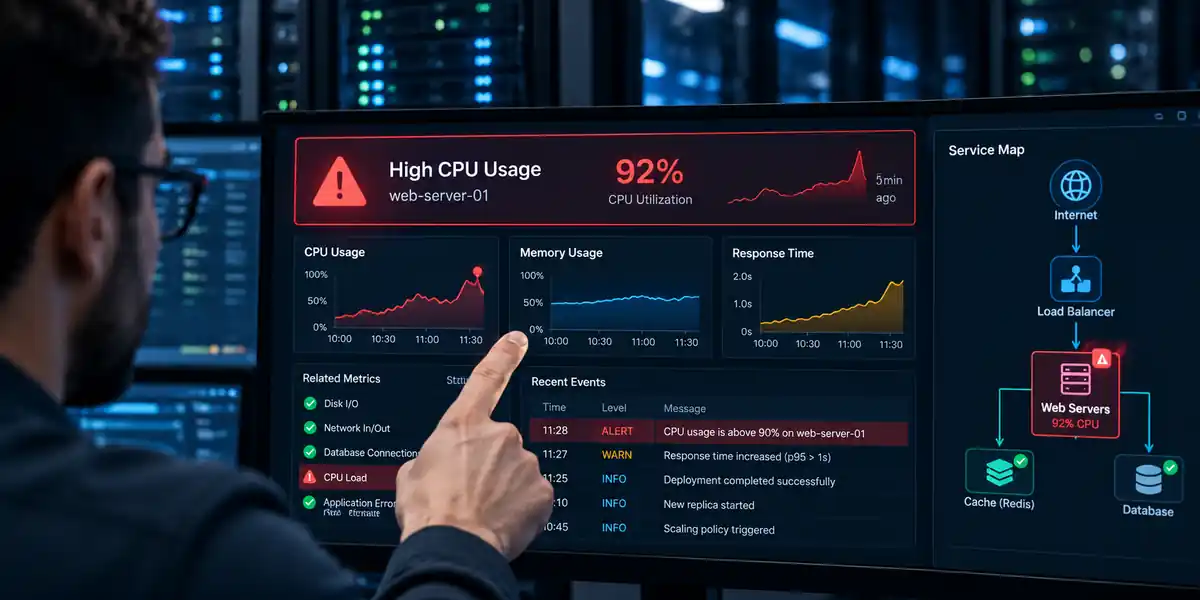
پس از تأیید مشکل، زمان اجرای پروتکلهای عملیاتی فرا میرسد. در این مرحله، تمرکز بر بازگرداندن سرویس به حالت کارکردی است، نه لزوماً یافتن علت اصلی آن.
تخصیص مسئولیتها و تشکیل تیم واکنش
در بحران، هر فرد باید بداند دقیقاً چه کاری باید انجام دهد. از سرزنش افراد در این مرحله پرهیز کنید؛ تمرکز بر فرآیند است.
- رهبر حادثه (Incident Commander): فردی که مسئول هماهنگی کلی، تصمیمگیری نهایی و ارتباط با مدیریت است.
- تیم فنی (Fixers): افرادی که مستقیماً روی کد، زیرساخت یا پیکربندی کار میکنند.
- تیم ارتباطات (Communicator): فردی که مسئول نگهداری مستندات و ارسال پیامهای رسمی است.
بررسی تغییرات اخیر و اقدام اصلاحی
بسیاری از قطعیها نتیجهی آخرین تغییرات است.
- بررسی Changelog: آخرین دیتای دیپلوی (Deployment) یا تغییر پیکربندی را بررسی کنید. آیا این تغییر، زمان شروع قطعی با تطابق دارد؟
- استراتژی کاهش اثر (Mitigation): اگر علت اصلی مشخص نیست، اولین هدف، کاهش آسیب است. آیا امکان بازگشت به آخرین نسخه پایدار (Rollback) وجود دارد؟ این کار سریعترین راه برای بازیابی سرویس است، حتی اگر مشکل ریشهای حل نشده باشد.
تفاوت رفع موقت و ریشهای:
- رفع موقت (Mitigation): هدف آن برگرداندن سرویس به حالت عملیاتی است (مثلاً Rollback یا افزایش منابع به صورت موقت). این کار باعث میشود کسبوکار شما دوباره درآمدزایی کند.
- رفع ریشهای (Root Cause Fix): هدف آن یافتن و حذف منبع اصلی مشکل است (مثلاً رفع باگ کد یا بهینهسازی دیتابیس). این کار باید پس از بازگشت سرویس انجام شود.
مرحله سوم: شفافیت و ارتباطات
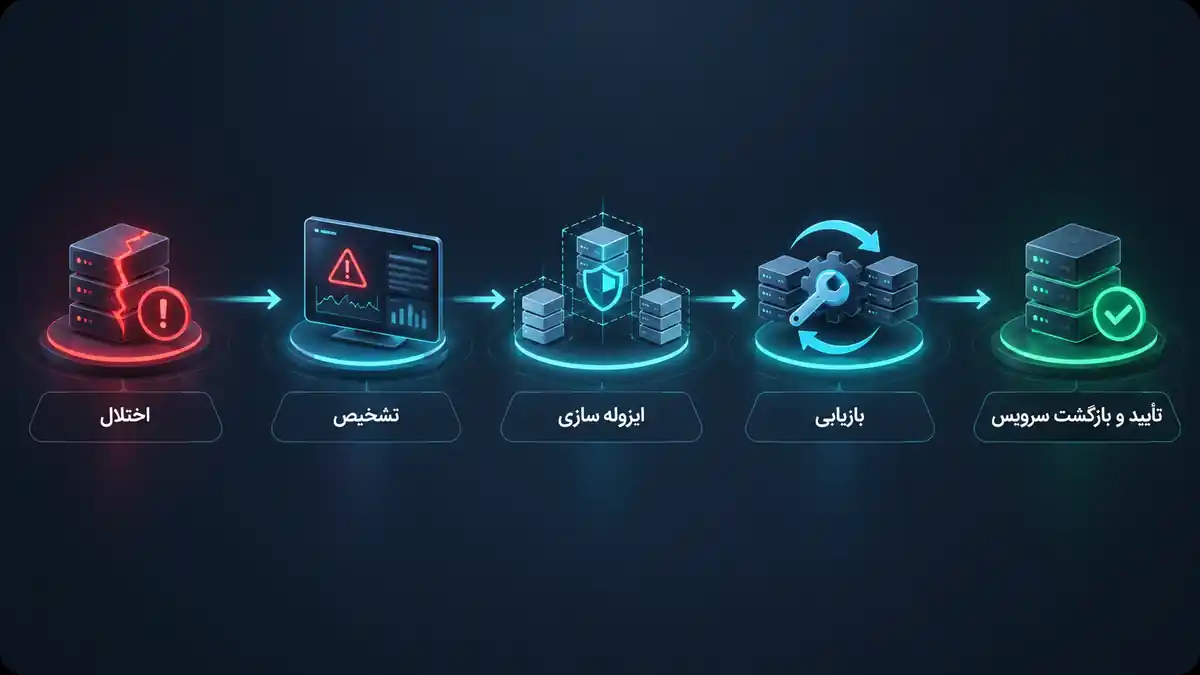
ارتباطات در زمان بحران، به اندازه خود رفع مشکل اهمیت دارد. سکوت، بدترین نوع ارتباط است.
ارتباط داخلی و مستندسازی
تیمهای مدیریتی و فروش نیاز به اطلاعاتی دارند که قابل فهم باشد، نه صرفاً اصطلاحات فنی.
- ثبت Timeline: یک مستند زنده (Incident Log) ایجاد کنید. هر اقدام، هر زمان و هر نتیجهای باید در آن ثبت شود. این مستند، شواهد شما در مراحل بعدی است.
- ارتباط داخلی: به تیمهای فروش و پشتیبانی اطلاع دهید که وضعیت چگونه است، اما از وعدههای قطعی زمانبندی شده پرهیز کنید.
پیامرسانی شفاف به مشتری
پیامهای شما باید کوتاه، صادقانه و بدون سرزنش باشند. هرگز قول ندهید که "سریعاً" حل میشود، مگر اینکه مطمئن باشید.
نمونه پیامها:
- شروع اختلال (Initial Alert): "ما از بروز اختلال در سرویس اطلاع داریم و تیمهای فنی ما در حال بررسی دقیق موضوع هستند. ما شما را در جریان پیشرفت کار قرار خواهیم داد."
- بهروزرسانی وضعیت (Update): "تیم ما در حال کار بر روی بازیابی سرویس هستیم. در حال حاضر، ما در حال اعمال یک راهکار موقت برای کاهش تأثیر هستیم. بهروزرسانی بعدی در [زمان مشخص] ارائه خواهد شد."
- پایان حادثه (Resolution): "سرویس ما به طور کامل بازیابی شده است. ما در حال انجام بررسیهای نهایی برای اطمینان از پایداری کامل هستیم. از صبر شما سپاسگزاریم."
برای اطمینان از اینکه هشدارهای شما در لحظه به درستی به دست افراد مسئول میرسد، استفاده از ابزارهای مانیتورینگ پیشرفته ضروری است. شما میتوانید دربارهی ویژگیهای این سرویس بیشتر در صفحه ویژگیها مطالعه کنید.
مرحله چهارم: پس از حادثه (Post-Mortem)
وقتی چراغ سبز بازگشت و سرویس پایدار شد، کار بحران تمام نشده است. این مرحله، سرمایهگذاری روی آینده است.
تحلیل علت ریشهای (RCA)
پس از آرام شدن اوضاع، تیم باید یک جلسه "Post-Mortem" برگزار کند. هدف این جلسه نه یافتن "مقصر"، بلکه یافتن "نقاط ضعف سیستمی" است.
- سوال کلیدی: چرا سیستم ما نتوانست این مشکل را به صورت خودکار مدیریت کند؟
- تدوین درسآموختهها: فهرستی از اقداماتی که باید در آینده برای جلوگیری از تکرار این سناریو انجام شود، تهیه کنید.
بهبود فرآیندها
این مرحله جایی است که شما از یک رویداد منفی به یک فرصت یادگیری تبدیل میکنید. آیا فرآیند اطلاعرسانی داخلی شما کند بود؟ آیا تستهای استرس کافی انجام نشده بودند؟
برای مطالعهی روشهای استاندارد مدیریت بحران و بهترین شیوهها در صنعت، میتوانید مقالات ما را در وبلاگ بررسی نمایید. این رویکرد سیستماتیک به شما کمک میکند تا نه تنها بحرانها را مدیریت کنید، بلکه از وقوع آنها در آینده پیشگیری نمایید.
در نهایت، مدیریت قطعی سایت یک مهارت تیمی است که با تمرین و داشتن یک پروتکل مشخص تقویت میشود. داشتن یک چارچوب منسجم، تضمین میکند که حتی در لحظات استرس بالا، تیم شما با هدف، آرام و حرفهای عمل خواهد کرد.
پایداری سایت شما در لحظات بحران
آیا تیم شما در لحظه قطعی سایت، از یک چارچوب عملیاتی مشخص برخوردار است؟ مانیتورینگ پیشرفته چکاو به شما کمک میکند تا هشدارهای کاذب را از مشکلات واقعی تشخیص داده و با یک پروتکل منسجم، سریعترین مسیر به بازیابی سرویس را طی کنید. با اطمینان از دیدن هر نوسان، آمادگی کامل برای مدیریت بحران را به دست آورید.
مطالب مرتبط
- چرا سایت فروشگاهی در روزهای حراج از دسترس خارج میشود و چطور زودتر بفهمیمقطعی سایت فروشگاهی در حراج نتیجه تعامل پیچیده بین ترافیک ناگهانی، محدودیتهای زیرساختی و وابستگیهای خارجی است. مدیران فنی باید دلایل فنی این خرابیها را درک کرده و با مانیتورینگ بیرونی، قبل از تماس مشتری، هشدار زودهنگام دریافت کنند.
- مانیتورینگ API چیست و چه شاخصهایی باید بررسی شوند؟مانیتورینگ API برای تضمین پایداری زیرساختهای مدرن و میکروسرویس حیاتی است. این مقاله به بررسی اهمیت مانیتورینگ API و شاخصهای کلیدی مانند وضعیتهای HTTP، تأخیر (Latency) و صحت محتوا میپردازد.
- مانیتورینگ سایت چیست و چرا برای کسبوکارهای آنلاین ضروری است؟مانیتورینگ سایت فراتر از بررسی بالا بودن سرویس است؛ این فرآیند نظارت مستمر بر شاخصهای عملکردی (KPIs) و وضعیت فنی زیرساختهای آنلاین شماست تا از قطعیها و افت عملکرد پیشگیری کرده و درآمد کسبوکار را تضمین نماید.