مانیتورینگ سایت چیست و چرا برای کسبوکارهای آنلاین ضروری است؟
- مانیتورینگ سایت
- DevOps
- عملکرد وبسایت
- SLA
- تجربه کاربری
مانیتورینگ سایت فراتر از بررسی بالا بودن سرویس است؛ این فرآیند نظارت مستمر بر شاخصهای عملکردی (KPIs) و وضعیت فنی زیرساختهای آنلاین شماست تا از قطعیها و افت عملکرد پیشگیری کرده و درآمد کسبوکار را تضمین نماید.
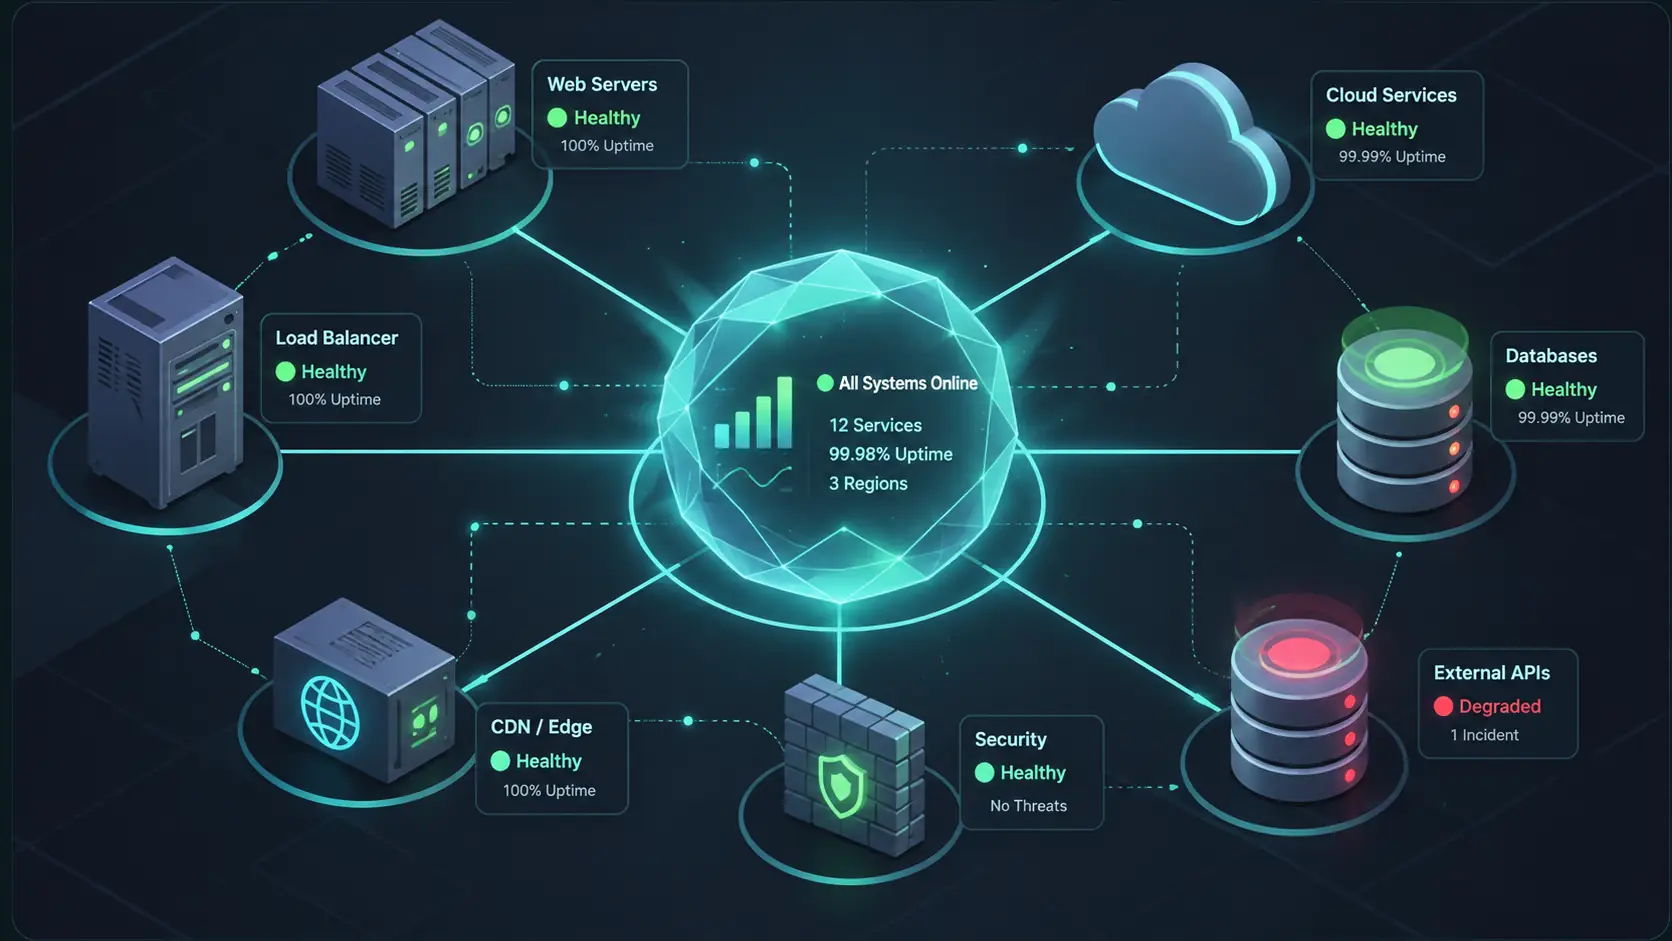
پایگاه عملیاتی هر کسبوکار آنلاین، در نهایت، عملکرد بیوقفه وبسایت یا اپلیکیشن آن است. وقتی کاربران به دنبال محصول، اطلاعات یا خدمتی هستند، انتظار دارند که تجربه آنها بدون وقفه و با سرعت بالا باشد. هرگونه قطعی، کندی یا خطای فنی، مستقیماً به کاهش اعتماد مشتری و از دست رفتن درآمد منجر میشود. در این میان، مانیتورینگ سایت به عنوان یک سیستم نظارتی حیاتی، نقش نگهبان شبانهروزی را ایفا میکند تا اطمینان حاصل شود که زیرساخت دیجیتال شما در بهترین حالت ممکن کار میکند.
مانیتورینگ سایت چیست و چرا حیاتی است؟
مانیتورینگ سایت فراتر از صرفاً «بررسی اینکه آیا سایت بالا میآید یا نه» است. این فرآیند شامل نظارت مستمر، خودکار و پیشگیرانه بر شاخصهای عملکردی (KPIs) و وضعیت فنی زیرساختهای آنلاین شماست. هدف اصلی، شناسایی مشکلات در لحظه وقوع یا حتی قبل از اینکه کاربر نهایی متوجه آن شود، است.
برای مدیران فنی و تیمهای DevOps، مانیتورینگ سایت ابزاری است برای حفظ SLAها (توافقنامههای سطح خدمات). اگر سرویسی شما دچار افت عملکرد شود، تأثیر آن میتواند بسیار گسترده باشد؛ از کاهش نرخ تبدیل (Conversion Rate) تا آسیب جدی به برند. با پیادهسازی یک سیستم قوی مانیتورینگ سایت، شما از حالت واکنشی (Reactive) به حالت پیشگیرانه (Proactive) تغییر وضعیت میدهید.
فراتر از دسترسپذیری: شاخصهای کلیدی نظارت
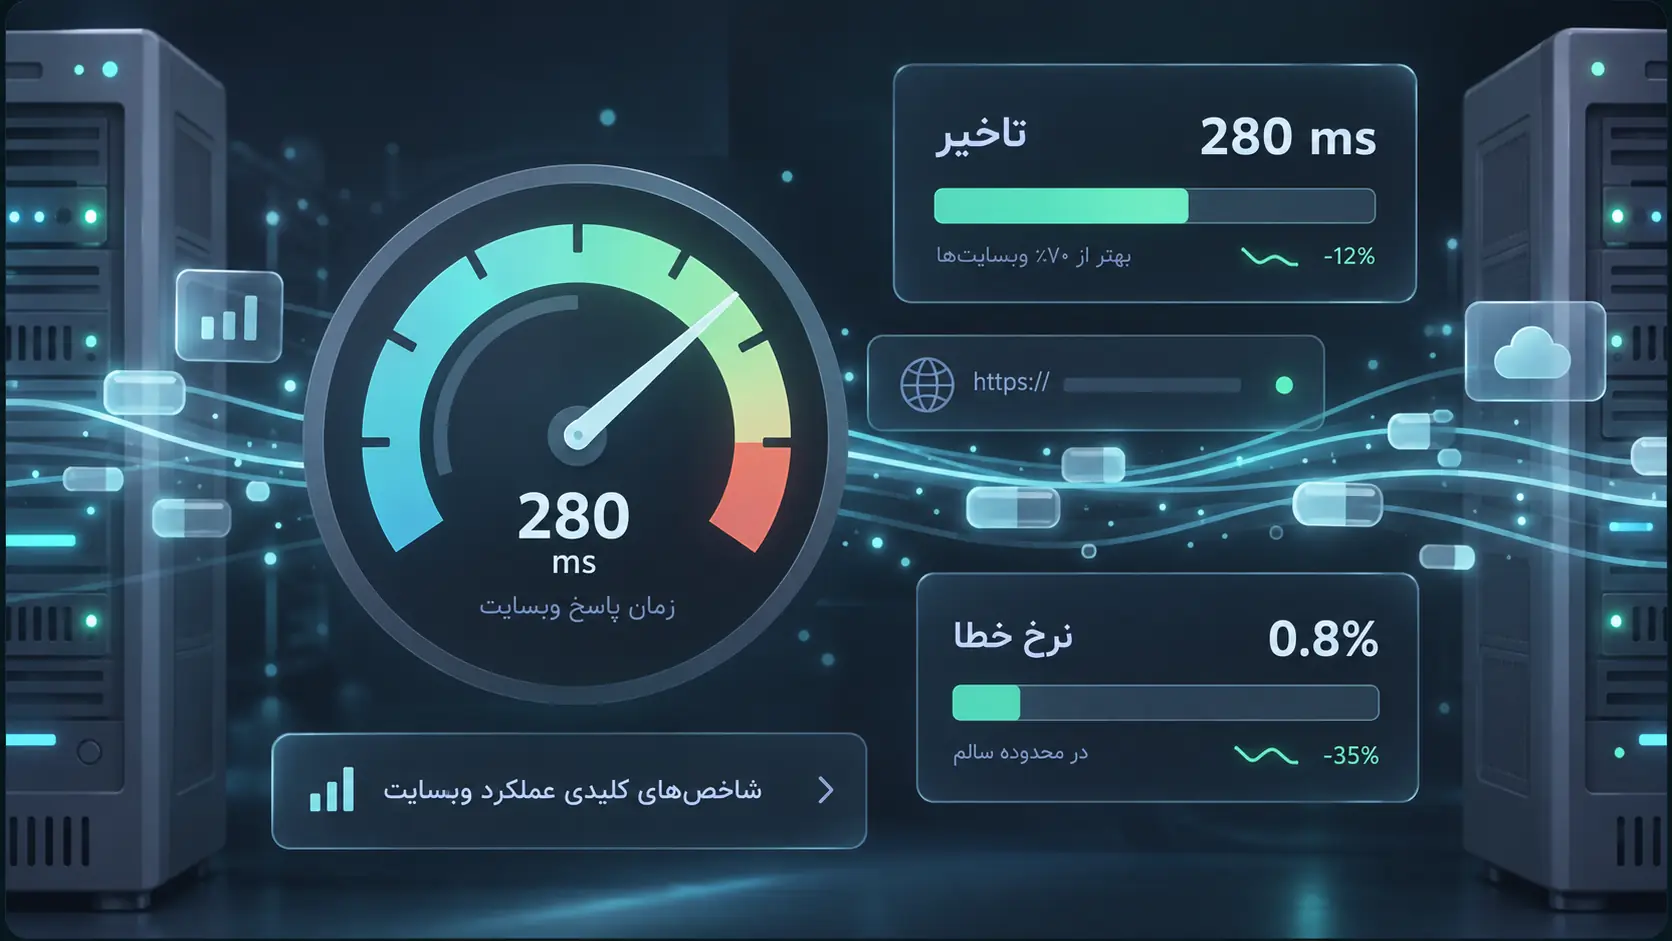
یک سیستم مانیتورینگ جامع، تنها وضعیت "بالا بودن" سرور را چک نمیکند. بلکه به دنبال معیارهای عمیقتری است. این شاخصها به شما کمک میکنند تا سلامت واقعی تجربه کاربری (User Experience) را بسنجید:
- Up-time (زمان فعال بودن): این سادهترین شاخص است؛ درصد زمانی که سرویس شما بدون وقفه در دسترس بوده است.
- Latency (تأخیر): مدت زمانی که طول میکشد تا درخواست کاربر به سرور برسد و پاسخ دریافت شود. تأخیر بالا مستقیماً با ناامیدی کاربر مرتبط است.
- Error Rate (نرخ خطا): فراوانی خطاهایی مانند ۴۰۴ (صفحه یافت نشد) یا ۵۰۰ (خطای سرور داخلی) که در طول زمان ثبت میشوند.
- Throughput (توان عملیاتی): میزان داده یا درخواستهایی که سیستم در یک بازه زمانی مشخص میتواند پردازش کند.
برای درک بهتر این مفاهیم و نحوه پیادهسازی، میتوانید نگاهی به ویژگیهای تخصصی پلتفرمهای مانیتورینگ در https://chekaav.com/fa/features بیندازید.
انواع رویدادها و خطاهایی که باید رصد شوند
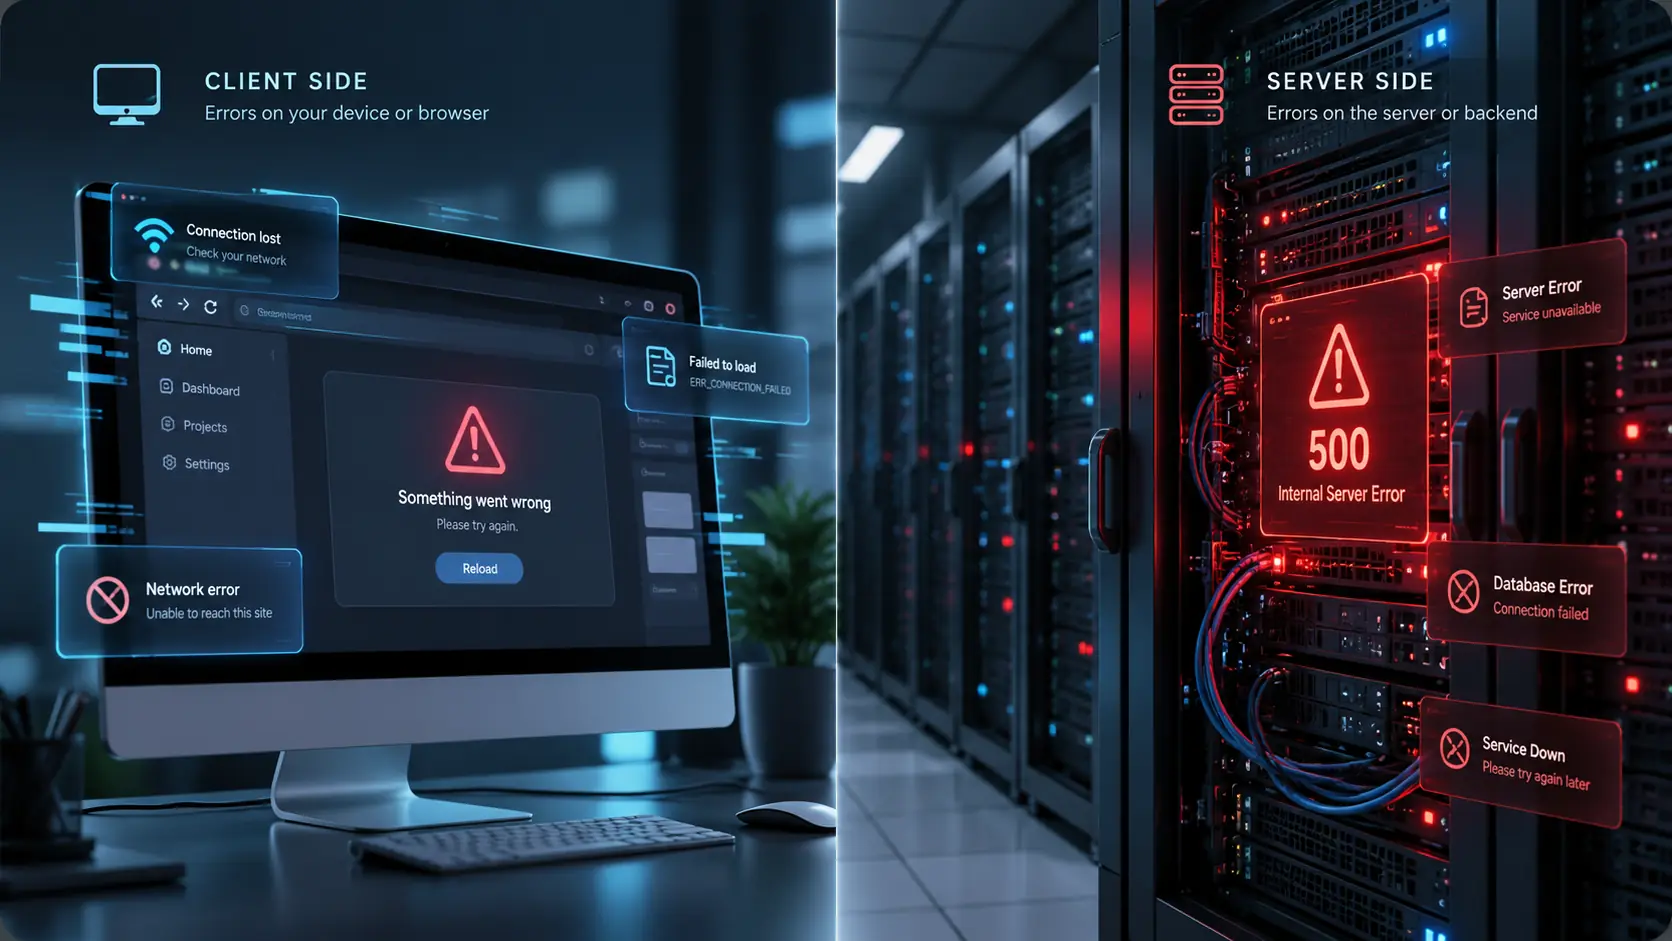
مشکلات فنی در محیطهای آنلاین بسیار متنوع هستند. تشخیص اینکه مشکل از شبکه است، از کدنویسی، از دیتابیس یا از زیرساخت ابری، نیازمند دید چندلایه است.
خطاهای سمت کاربر (Client-Side Errors)
این خطاها مستقیماً در مرورگر کاربر رخ میدهند. مثلاً اسکریپتهای جاوااسکریپت به درستی بارگذاری نشدهاند یا منابع (تصاویر، فایلهای CSS) در مسیر اشتباهی قرار دارند. مانیتورینگ باید بتواند این موارد را از طریق شبیهسازی مرورگرها رصد کند.
خطاهای سمت سرور (Server-Side Errors)
اینها معمولاً به دلیل بارگذاری بیش از حد، کوئریهای دیتابیس سنگین یا باگهای منطقی در کد رخ میدهند. اگر سرور نتواند درخواستها را به موقع پردازش کند، منجر به افزایش شدید Latency و نرخ خطای ۵۰۰ میشود.
مشکلات زیرساختی و شبکه
این دسته شامل قطعیهای ارتباطی بین سرویسها (Microservices)، مشکلات DNS یا از دست رفتن اتصال به سرویسهای خارجی (مانند درگاههای پرداخت) است. مانیتورینگ باید بتواند این وابستگیها (Dependencies) را نیز پایش کند.
چالشهای رایج در پیادهسازی مانیتورینگ
بسیاری از تیمها در شروع کار با مانیتورینگ با چالشهایی روبرو میشوند که اگر پیشبینی نشوند، سیستم نظارتی شما تبدیل به یک نویز (Noise) بزرگ میشود.
بیش از حد هشدار (Alert Fatigue)
بزرگترین دشمن مانیتورینگ، حجم بیرویه هشدارهایی است که تولید میکند. اگر سیستم شما برای هر افزایش جزئی در مصرف CPU هشدار دهد، تیم شما به مرور زمان شروع به نادیده گرفتن همه هشدارها میکند. کلید موفقیت، تنظیم آستانههای هوشمند و تعریف شرایط بحرانی واقعی است.
عدم پوشش کامل (Blind Spots)
اگر فقط وضعیت سرور اصلی را چک کنید، ممکن است سرویسهای فرعی (مانند کش یا APIهای پشتیبان) دچار مشکل شوند، اما سیستم شما متوجه نشود. یک استراتژی مانیتورینگ موفق، باید تمام نقاط حساس مسیر کاربر را پوشش دهد. برای درک بهتر چگونگی مدیریت این نقاط، میتوانید مقالات تخصصیتر در https://chekaav.com/fa/blog مطالعه کنید.
تبدیل داده به اقدام عملی
هدف نهایی مانیتورینگ، تولید گزارش نیست؛ بلکه حل مسئله است. وقتی سیستمی مانند چکاو، یک اختلال را شناسایی میکند، باید فرآیند رسیدگی به آن به صورت خودکار یا با حداقل مداخله انسانی آغاز شود.
چکلیست عملی برای شروع مانیتورینگ
اگر قصد دارید فرآیند مانیتورینگ را در سازمان خود آغاز کنید، این چکلیست میتواند نقطه شروع خوبی باشد:
- تعریف SLAها: مشخص کنید که برای هر سرویس، زمان پاسخگویی و زمان فعال بودن مورد انتظار چقدر است.
- انتخاب نقاط نظارتی (Checkpoints): حداقل سه نقطه کلیدی (مثلاً صفحه اصلی، صفحه پرداخت، API اصلی) را برای پایش انتخاب کنید.
- تنظیم آستانهها: برای هر شاخص (Latency، Error Rate) یک آستانه بحرانی مشخص کنید که در صورت عبور از آن، هشدار صادر شود.
- تعیین مسیر هشدار: مشخص کنید که هشدار باید به چه کسی، از چه طریق (ایمیل، پیامک، Slack) و در چه اولویتی ارسال شود.
در نهایت، مانیتورینگ سایت یک سرمایهگذاری است، نه یک هزینه. این سیستم به شما امکان میدهد تا با اطمینان بیشتری بر روی توسعه ویژگیهای جدید تمرکز کنید، زیرا میدانید که زیرساخت شما تحت نظارت دقیق قرار دارد. برای بررسی مدلهای مختلف ارائه خدمات، میتوانید به صفحه https://chekaav.com/fa/pricing مراجعه نمایید.
عملکرد سایت شما در خطر است؟
اگر نمیدانید که دقیقاً چه زمانی و چرا سایت شما کند شده یا دچار خطا میشود، در حال از دست دادن اعتماد مشتری و درآمد هستید. سیستم مانیتورینگ چکاو به شما دید لحظهای و پیشگیرانه میدهد تا زیرساخت دیجیتال خود را همیشه در اوج کارایی نگه دارید و از هرگونه اختلال ناخواسته جلوگیری نمایید.